En el informe Page indexing (Indexación de páginas) ves Discovered - currently not indexed, que en la interfaz en español aparece como «Descubierta: actualmente sin indexar», junto a un número de URLs que no se va. Cuando inspeccionas una, Last crawl (último rastreo) dice N/A, lo que significa que Google sabe que la página existe, seguramente por tu sitemap o por un enlace, pero no la ha descargado.
La ayuda de Google explica el motivo habitual: Google quería rastrear la URL, pero calculó que hacerlo podía sobrecargar el sitio y reprogramó el rastreo. En sitios pequeños, sin embargo, la causa suele tener más que ver con prioridades que con la carga del servidor. Google encontró la URL, la comparó con todo lo demás que esperaba turno y decidió que podía esperar.
Así que el arreglo se divide en dos preguntas: ¿tu servidor aguanta más rastreo?, y ¿le estás dando a Google una lista clara y corta de páginas que valgan la pena, con enlaces que demuestren que importan? Esta guía explica cómo revisar ambas cosas y qué cambiar.
Las capturas muestran Search Console en inglés, así que dejamos en negritas el nombre en inglés de cada botón o menú y, cuando ayuda, su equivalente en español.
Respuesta rápida
- Inspecciona algunas URLs afectadas para confirmar que Last crawl está vacío y que nada las bloquea.
- Abre Settings > Crawl stats > Open report (Configuración > Estadísticas de rastreo) y revisa el estado del host, Average response time y el desglose By response en busca de problemas del servidor.
- Recorta el rastreo inútil: deja de generar o enlazar URLs con parámetros, filtros, etiquetas o duplicadas.
- Enlaza las páginas importantes atoradas desde el inicio, los menús y páginas relacionadas que ya estén indexadas.
- Mantén limpio tu sitemap (solo URLs indexables y canónicas, con fechas
lastmodhonestas), solicita la indexación de unas cuantas páginas clave y espera de dos a cuatro semanas.
Antes de empezar
Necesitas acceso de Owner (propietario) o Full user (usuario con permisos totales) en Search Console para solicitar la indexación. La ayuda de Google dice que el informe Crawl stats solo está disponible en propiedades a nivel raíz, es decir, una propiedad de dominio o una de prefijo de URL en la raíz del sitio, como https://www.example.com/. Si solo tienes una propiedad de una subcarpeta, pide al propietario que te agregue a la raíz.
Ten acceso al panel de tu hosting o a los registros del servidor, y a tu CMS y plugin de SEO. Si el problema resulta ser la velocidad o los errores del servidor, vas a necesitar a tu desarrollador o a tu proveedor de hosting. Antes de cambiar robots.txt o quitar URLs, guarda una copia del archivo robots.txt actual y de tu sitemap.
Paso 1: Mide el tamaño del problema
Ve a Indexing > Pages y baja hasta Why pages aren't indexed. Busca Discovered - currently not indexed y fíjate en su Source (fuente): Google systems. Eso significa que, en sentido estricto, nada está roto en tu sitio; Google decidió esperar.
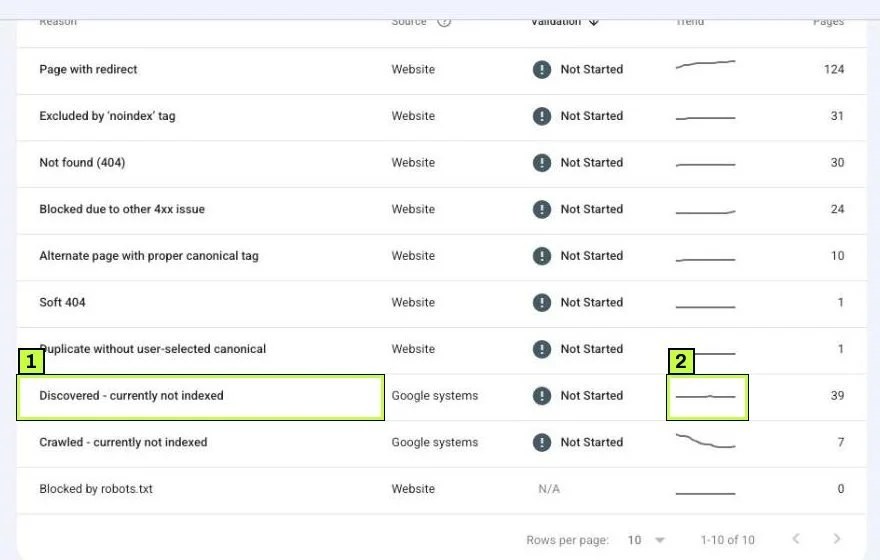
Haz clic en la fila. El detalle muestra First detected (detectado por primera vez), el botón VALIDATE FIX y una gráfica de Affected pages (páginas afectadas) en el tiempo.
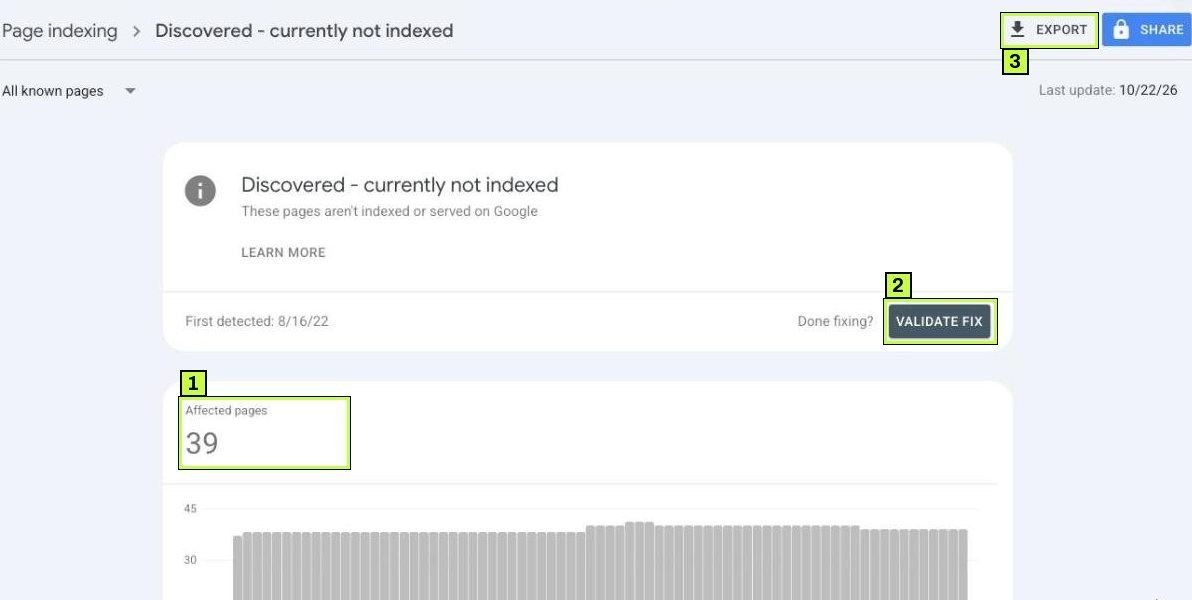
Una línea plana como la de esta cuenta de ejemplo suele indicar un rezago estable. Una línea que sube sin parar significa que Google sigue encontrando URLs nuevas más rápido de lo que quiere rastrearlas.
Exporta la lista y ordénala por ruta de URL. Suelen aparecer dos situaciones muy distintas.
- Unas cuantas páginas nuevas, como los artículos de la semana pasada. Muchas veces es solo una fila de espera y se resuelve sola en días o semanas.
- Cientos o miles de URLs parecidas con parámetros (
?color=,?sort=,?sessionid=), combinaciones de filtros, páginas de calendario o archivos de etiquetas. Eso es rastreo desperdiciado y es lo principal que hay que arreglar.
Paso 2: Inspecciona una muestra de URLs
Pega de tres a cinco URLs afectadas en la barra Inspect any URL in de arriba de Search Console. Escoge tanto páginas importantes como otras que parezcan basura, para comparar cómo las encontró Google. La fila Page indexing dirá el motivo y, al desplegarla, la sección Discovery (descubrimiento) muestra de dónde salió la URL.
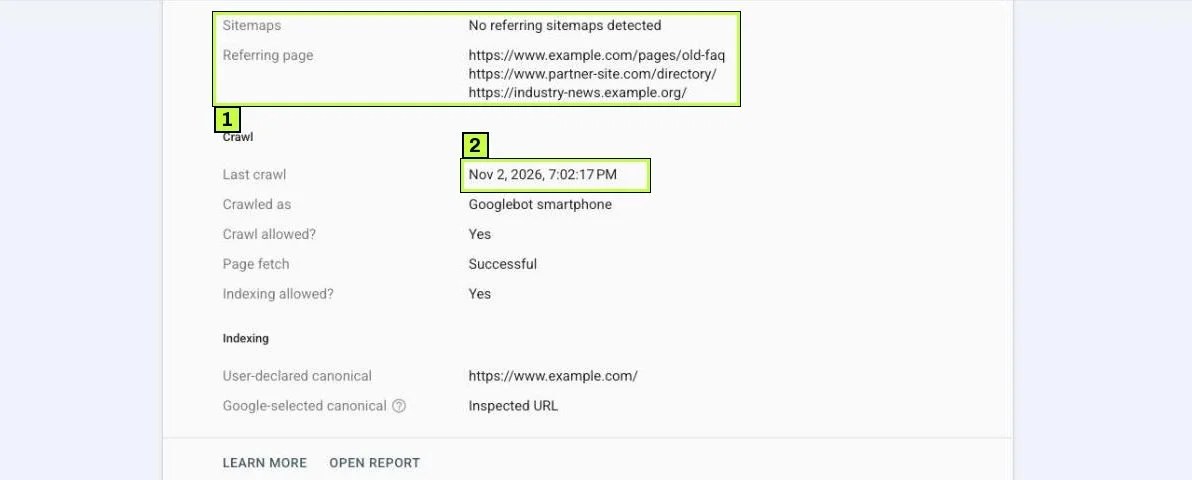
- Sitemaps te dice si la URL vino de un sitemap que enviaste. No referring sitemaps detected en una página importante significa que falta en tu sitemap.
- Referring page (página de referencia) muestra páginas que enlazan a la URL. En las URLs basura, suele ser la pista del origen del rastreo desperdiciado, como un enlace de filtro en una página de categoría.
Corre Test live URL en las importantes. Si la prueba falla porque robots.txt bloquea la URL o el servidor devuelve un error, arregla eso primero. Si la prueba dice URL is available to Google (la URL está disponible para Google) y simplemente no se ha rastreado, pasa a revisar el servidor.
Paso 3: Revisa la salud del servidor en Crawl stats
Haz clic en Settings en el menú de la izquierda. En la sección Crawling (rastreo), busca Crawl stats y haz clic en Open report. El informe cubre más o menos los últimos 90 días de actividad de Googlebot.
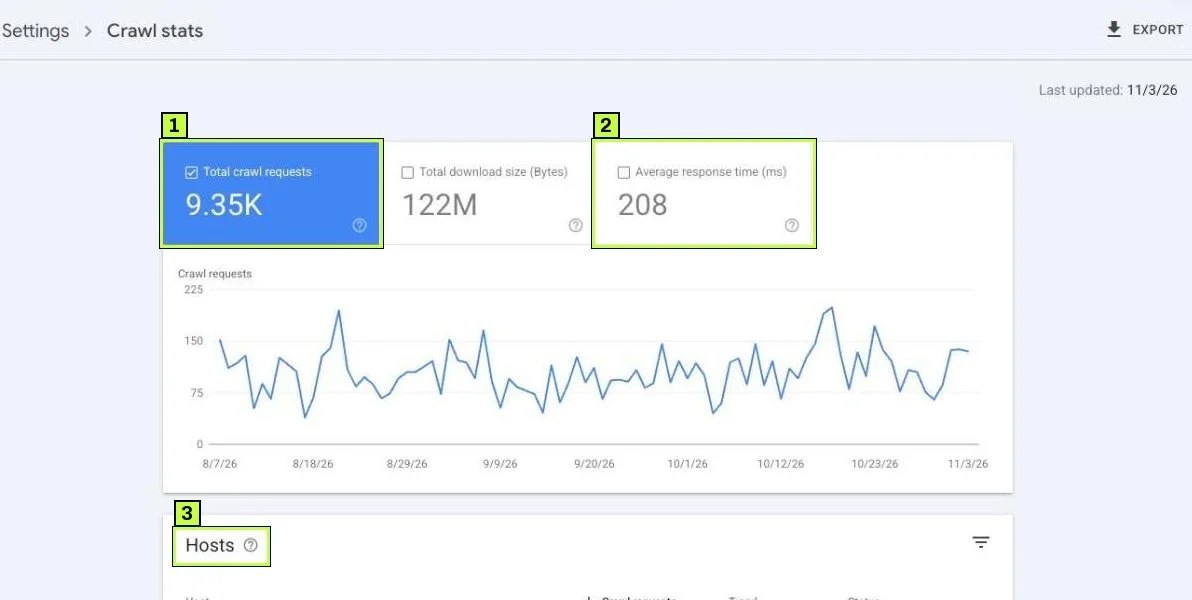
Arriba hay tres recuadros: Total crawl requests (solicitudes de rastreo), Total download size (Bytes) (tamaño total de descarga) y Average response time (ms) (tiempo medio de respuesta). Debajo de la gráfica, una propiedad de dominio lista cada host (por ejemplo www.example.com y otros subdominios) en una tabla Hosts con su estado; haz clic en un host para ver el detalle. Según la ayuda de Google, el estado del host revisa tres cosas: robots.txt fetching (obtención de robots.txt), DNS resolution (resolución de DNS) y Server connectivity (conectividad del servidor).
Más abajo, Crawl requests breakdown (desglose de solicitudes) agrupa los rastreos By response (por respuesta), By file type (por tipo de archivo), By purpose (por propósito) y By Googlebot type (por tipo de Googlebot).
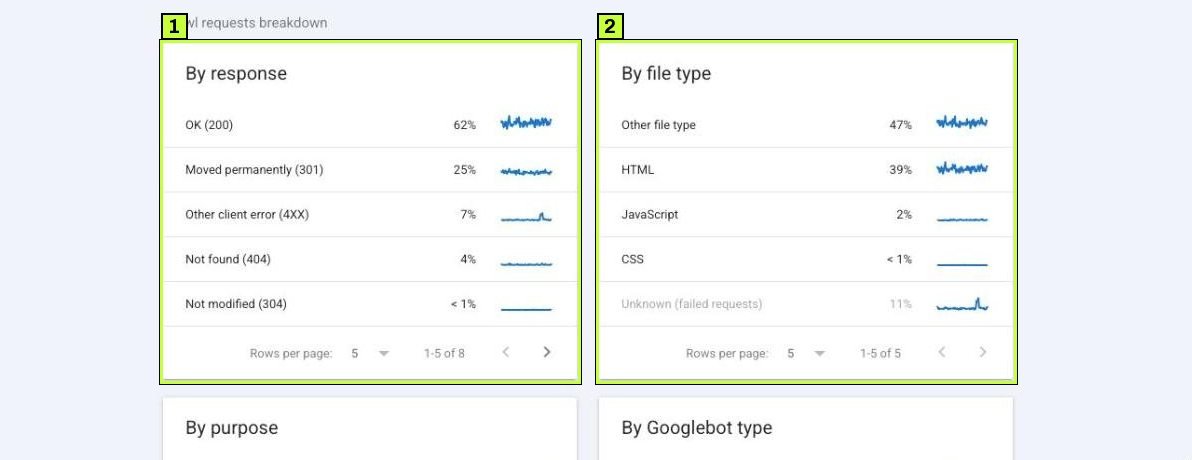
Así se lee el informe y esto significa cada alerta para ti.
- El estado del host muestra problemas. Las fallas al obtener robots.txt, al resolver el DNS o al conectar con el servidor hacen que Google baje el ritmo o pause el rastreo. Comparte las fechas afectadas con tu hosting para que las cruce con sus registros.
- El tiempo de respuesta es alto o va subiendo. La guía de Google sobre presupuesto de rastreo dice que el rastreo sube cuando el sitio responde rápido y baja cuando se vuelve lento o da errores. Las causas habituales son consultas lentas a la base de datos, un hosting compartido saturado o falta de caché de páginas. La caché y un mejor plan de hosting suelen ayudar más que cualquier cambio de SEO.
- Muchas respuestas 5xx o 429 en By response. La misma guía dice que los errores del servidor y las señales de límite de solicitudes, como el código 429, reducen el límite de rastreo. Averigua qué falla (un plugin, una regla del firewall o un límite de tasa) y corrígelo.
- Una buena parte del rastreo va a redirecciones o 404. Google está gastando tiempo en callejones sin salida, así que actualiza los enlaces internos para que apunten directo a la URL final.
Revisa que tu firewall, CDN o plugin de seguridad no esté limitando ni desafiando a Googlebot. A veces la protección contra bots trata al rastreador de Google como un atacante, y el tráfico verificado de Googlebot debe recibir respuestas normales.
Si el estado del host está limpio y los tiempos de respuesta son estables, probablemente la capacidad del servidor no es el problema. Concéntrate en los dos pasos siguientes.
Paso 4: Recorta las URLs que Google no necesita
Cada URL innecesaria que Google conoce compite por atención con tus páginas reales. La guía de Google sobre presupuesto de rastreo pone el manejo de tu inventario de URLs en primer lugar entre lo que sí controlas. Los sitios pequeños rara vez llegan al límite de rastreo, pero una tienda con enlaces de filtros puede generar miles de URLs a partir de unas cuantas decenas de productos.
Trabaja sobre los patrones que encontraste en el paso 1.
| Origen de las URLs de más | Arreglo |
|---|---|
| Filtros por facetas y opciones de orden | No generes enlaces rastreables para cada combinación; usa canónicas a la categoría principal; bloquea en robots.txt los parámetros que solo ordenan, si hace falta |
| IDs de sesión o parámetros de seguimiento en enlaces internos | Quítalos de los enlaces internos; no uses UTM en la navegación interna |
| Calendarios o archivos por fecha infinitos | Limita el rango, o pon noindex y deja de enlazar fechas muy futuras |
| Archivos de etiquetas con un solo artículo | Fusiona etiquetas, o pon noindex y sácalas del sitemap |
| Versiones duplicadas http/https o con y sin www | Redirige con 301 a una sola versión en todo el sitio |
| Páginas de resultados de búsqueda interna | No las enlaces; bloquea /search o /?s= en robots.txt |
| Soft 404 y páginas vacías | Devuelve un 404 real o agrega contenido |
| Páginas eliminadas para siempre | Devuelve 404 o 410 |
Una nota sobre robots.txt. La guía de Google sobre presupuesto de rastreo sugiere robots.txt para URLs que nunca quieres que se rastreen, porque una página con noindex igual se solicita y luego se descarta. Pero el bloqueo también oculta cualquier canónica o noindex en esas páginas, y la guía advierte que no uses robots.txt para mover el rastreo temporalmente a otras páginas. Bloquea solo patrones de URL que no aporten nada y nunca bloquees páginas que quieres indexar. En nuestra guía de robots.txt y noindex explicamos ese equilibrio. Este ejemplo solo impide el rastreo de los parámetros de orden y de sesión:
User-agent: *
Disallow: /*?*sort=
Disallow: /*?*sessionid=

Sitemap: https://www.example.com/sitemap.xml
Pruébalo antes de confiar en él. Revisa cada regla nueva con URL inspection sobre algunas URLs importantes. Un comodín mal puesto puede bloquear una sección entera.
Paso 5: Haz que las páginas importantes sean fáciles de alcanzar
Google decide qué rastrear en parte según qué tan importante parece una URL. Las páginas huérfanas son las que más sufren. Las que solo aparecen en un sitemap, sin enlaces internos, parecen poco importantes.
Para cada página importante atorada en este estado:
- Enlázala desde el inicio, la navegación principal o una página de categoría o central.
- Agrega dos o tres enlaces en contexto desde páginas relacionadas que ya estén indexadas.
- Mantenla a pocos clics del inicio. La paginación profunda (la página 14 del blog) es un camino débil.
- Usa enlaces normales
<a href>. Los enlaces que solo funcionan con un evento de clic en JavaScript pueden no seguirse.
<!-- Rastreable -->
<a href="/guias/mantenimiento-de-techos/">Guía de mantenimiento de techos</a>

<!-- Riesgoso: no hay href que Google pueda seguir -->
<span onclick="go('/guias/mantenimiento-de-techos/')">Guía de mantenimiento de techos</span>
Los enlaces externos también ayudan, porque una mención desde un sitio relevante le dice a Google que vale la pena descargar la página.
Paso 6: Limpia tu sitemap y solicita la indexación
Abre Indexing > Sitemaps y revisa tus sitemaps enviados. Cada uno debe incluir solo URLs que devuelvan 200, sean indexables y sean su propia canónica. Quita redirecciones, 404, páginas con noindex y URLs con parámetros. Un sitemap lleno de basura diluye la señal.
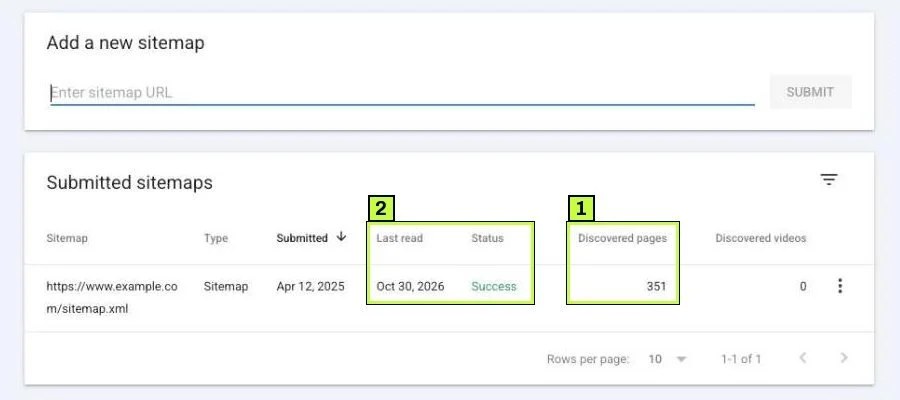
Si un sitemap lista muchas más URLs que páginas reales tienes, probablemente está lleno de variantes o parámetros. Para ver cuántas URLs del sitemap están atoradas, abre Indexing > Pages y cambia el menú All known pages (todas las páginas conocidas) de arriba a tus páginas enviadas o a un sitemap específico.
Usa lastmod con honestidad y actualízalo solo cuando el contenido cambie de verdad. La guía de Google recomienda <lastmod> para el contenido actualizado, y las fechas que cambian en cada publicación del sitio vuelven inútil el campo.
<url>
  <loc>https://www.example.com/guias/mantenimiento-de-techos/</loc>
  <lastmod>2026-10-30</lastmod>
</url>
Después inspecciona tus cinco a diez URLs atoradas más importantes y haz clic en Request indexing en cada una. Con eso basta. Google limita estas solicitudes por propiedad y por día, y su documentación dice que pedir la misma URL varias veces no la rastrea más rápido.
¿Sigue sin funcionar? Causas comunes
| Síntoma | Causa probable | Solución |
|---|---|---|
| El conteo sube por miles de un día a otro | Un filtro, calendario o parámetro nuevo está generando URLs | Encuentra el patrón en la exportación; quita los enlaces o usa canónicas |
| Los artículos nuevos se quedan aquí semanas | Pocos enlaces internos; el sitio publica más de lo que Google quiere rastrear | Enlaza los artículos nuevos desde el inicio y artículos relacionados; publica menos páginas y más fuertes |
| Crawl stats muestra muchos errores 5xx | Servidor saturado, errores de plugins, límites del hosting | Corrige los errores, agrega caché, mejora el hosting |
| Crawl stats muestra respuestas 429 | El firewall, CDN o WAF limita a Googlebot | Permite a Googlebot verificado en tus reglas de bots |
| Respuesta de más de uno o dos segundos | Servidor lento, sin caché de páginas, consultas pesadas | Agrega caché de páginas y un CDN; optimiza las plantillas más lentas |
| La inspección dice No referring sitemaps detected y no hay página de referencia | Página huérfana que falta en el sitemap | Agrégala al sitemap y enlázala desde la navegación o páginas relacionadas |
| Todas las variantes de producto atoradas | Cada variante tiene su URL con contenido casi idéntico | Canonicaliza las variantes a la URL principal del producto |
| El estado cambia a Crawled - currently not indexed | Google rastreó y luego decidió no indexar | Revisa cómo solucionar «Rastreada: actualmente sin indexar» |
| Páginas atoradas tras una migración | URLs viejas y nuevas activas, cadenas de redirección | Redirecciones 301 de un solo salto; actualiza enlaces internos y sitemaps |
Sitios grandes y presupuesto de rastreo
La guía de Google sobre presupuesto de rastreo está pensada para sitios grandes (aproximadamente un millón o más de páginas únicas que cambian cada semana, o 10,000 o más que cambian a diario) y para sitios con una gran parte de sus URLs en este estado exacto. Google aclara que esas cifras son una estimación aproximada. Si es tu caso, léela completa. Los mismos pasos aplican a mayor escala: primero la capacidad del servidor, luego el inventario de URLs y después los enlaces internos. Devuelve 404 o 410 para las páginas eliminadas para siempre en lugar de bloquearlas, porque la guía señala que las URLs bloqueadas se quedan mucho más tiempo en la fila de rastreo.
Es normal que una página nueva espere
Una página nueva en este estado durante unos días no es un problema. La documentación de Google dice que el rastreo puede tardar desde unos días hasta unas semanas, así que empieza a investigar solo si las páginas se quedan aquí varias semanas o el conteo sigue subiendo.
Cómo confirmar que quedó resuelto
- Vuelve a inspeccionar las URLs clave en una o dos semanas. Lo que quieres es que aparezca una fecha en Last crawl. Después, el estado debería cambiar a indexada, o a Crawled - currently not indexed si Google la rastreó pero decidió no incluirla.
- Revisa otra vez Crawl stats. Los tiempos de respuesta deben estar más estables y el estado del host limpio. Las solicitudes de rastreo suelen subir cuando el servidor responde más rápido.
- Vigila la tendencia de Discovered en Indexing > Pages. Debe aplanarse y luego bajar, a medida que salen las URLs basura y se rastrean las buenas.
- Haz clic en Validate fix en el motivo cuando tus cambios estén publicados. La ayuda de Google dice que la validación suele tardar hasta unas dos semanas, aunque puede tardar más. Cuenta con que termine en Failed si todavía aparecen URLs basura.
- Revisa Performance (Rendimiento) para ver impresiones en las páginas recién indexadas.
Dale de dos a cuatro semanas en sitios pequeños. Los cambios en el rastreo tardan en reflejarse en el informe, y las URLs con parámetros pueden quedarse en la lista mucho después de que dejaste de enlazarlas.
Preguntas frecuentes
¿«Descubierta: actualmente sin indexar» es malo?
No por sí solo. Que unas cuantas URLs recientes estén en este estado es normal. Se vuelve un problema cuando las páginas importantes se quedan aquí semanas o el conteo no deja de subir.
¿Sirve volver a enviar mi sitemap?
Casi nunca. Google vuelve a leer los sitemaps por su cuenta; su ayuda sugiere reenviarlo solo después de cambios grandes o de corregir un error de descarga. Arreglar lo que contiene el sitemap ayuda más.
¿Debo bloquear estas URLs en robots.txt?
Solo si no aportan nada y nunca quieres que se rastreen, como las variantes infinitas de orden. Nunca bloquees páginas que quieres indexar, y recuerda que el bloqueo oculta tus etiquetas canónicas y noindex.
¿Un hosting más rápido lo resuelve?
A veces. Si Crawl stats muestra respuestas lentas o errores del servidor, suele ayudar mucho. Si el servidor ya es rápido, el problema probablemente está en las URLs desperdiciadas o en enlaces débiles.
¿Cuántas páginas puedo enviar a indexar por día?
Google no publica una cifra exacta, solo dice que hay un límite diario por propiedad. Úsalo para tus páginas más importantes y deja que el sitemap se encargue del resto.
¿Te atoraste con esto? Lo resolvemos para clientes cada semana. Agenda una auditoría gratis
