Abres el informe Page indexing (Indexación de páginas) en Search Console y ves una fila llamada Crawled - currently not indexed, que en la interfaz en español aparece como «Rastreada: actualmente sin indexar». Algunas de esas URLs son artículos o páginas de servicio que te importan, y no aparecen en Google por ningún lado.
Este estado significa que Googlebot visitó la página, la leyó y decidió no agregarla al índice, al menos por ahora. Nada técnico lo impidió. No hay código de error, ni bloqueo en robots.txt, ni noindex. Google simplemente consideró que la página todavía no vale la pena guardarla, o aún no termina de procesarla.
Eso la hace distinta de casi todos los errores de indexación, porque no hay un ajuste que cambiar. Se arregla decidiendo qué URLs merecen de verdad estar indexadas, haciendo que esas páginas sean claramente útiles y distintas, y limpiando el resto para que Google dedique su atención a lo correcto. La ayuda de Google dice que es un mensaje común porque Google no indexa todas las páginas de la web, así que es normal que algunas URLs se queden en la lista sin que pase nada.
Las capturas muestran Search Console en inglés, así que dejamos en negritas el nombre en inglés de cada botón o menú y, cuando ayuda, su equivalente en español.
Respuesta rápida
- Abre Indexing > Pages, haz clic en Crawled - currently not indexed y exporta los ejemplos. Sepáralos en "debe indexarse" y "no importa".
- Inspecciona algunas URLs importantes con URL inspection (Inspección de URLs) para descartar un retraso del informe y confirmar que la página se renderiza completa.
- En las páginas que importan, corrige el contenido pobre, duplicado o desactualizado y agrega enlaces internos desde páginas fuertes.
- En las que no importan, deja de generarlas, consolídalas con redirecciones o canónicas, o simplemente déjalas.
- Solicita la indexación de tus páginas clave ya corregidas, haz clic en Validate fix (Validar corrección) y dale de dos a cuatro semanas.
Antes de empezar
Necesitas acceso de Owner (propietario) o Full user (usuario con permisos totales) en la propiedad de Search Console, porque solo esos roles pueden solicitar la indexación. Una hoja de cálculo te ayuda a ordenar la lista exportada. Si el sitio está en WordPress, Shopify u otro CMS, ten a la mano un usuario editor para actualizar contenido y enlaces.
En un sitio pequeño, calcula de una a dos horas. Casi todo ese tiempo se va en revisar páginas, no en hacer clics. Antes de reescribir o fusionar algo, guarda una copia del contenido actual y anota cada URL que pienses redirigir, para poder revertir si cae el tráfico.
Paso 1: Abre el informe y exporta la lista
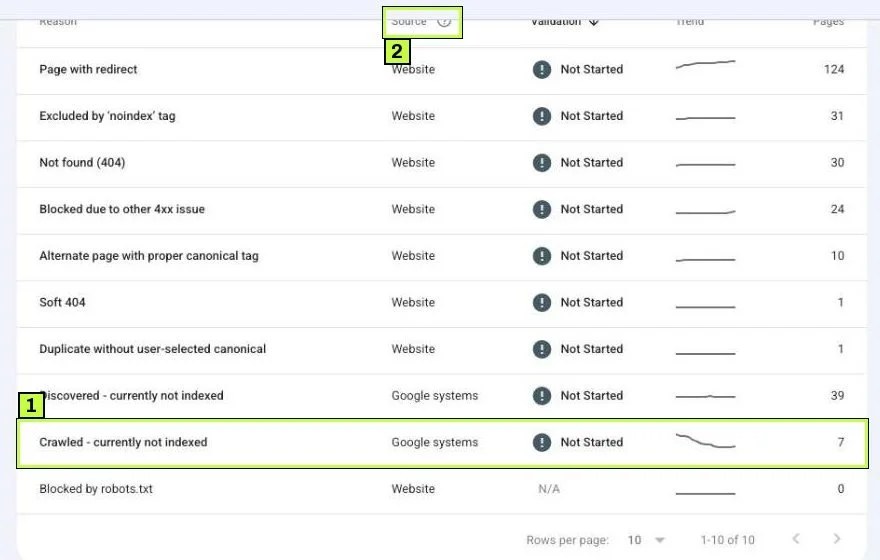
En Search Console, ve a Indexing > Pages. Baja hasta la tabla Why pages aren't indexed (por qué hay páginas sin indexar) y busca la fila Crawled - currently not indexed. Fíjate en la columna Source (fuente): dice Google systems, no Website. La ayuda de Google explica que la fuente indica si el problema viene de Google o de tu sitio, y que en general solo puedes corregir directamente los que vienen del sitio. Aquí solo puedes influir en la decisión de Google.
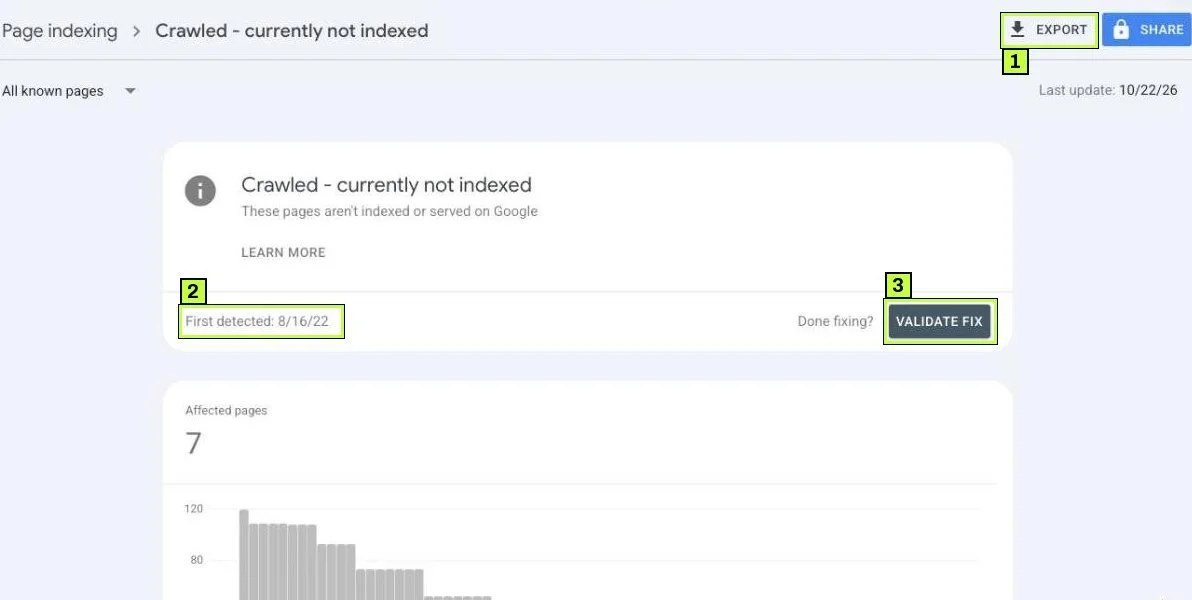
Haz clic en la fila para abrir el detalle. Arriba verás el motivo, la fecha First detected (detectado por primera vez) y Done fixing? junto al botón VALIDATE FIX. Export, arriba a la derecha, descarga los ejemplos a Google Sheets, Excel o CSV.
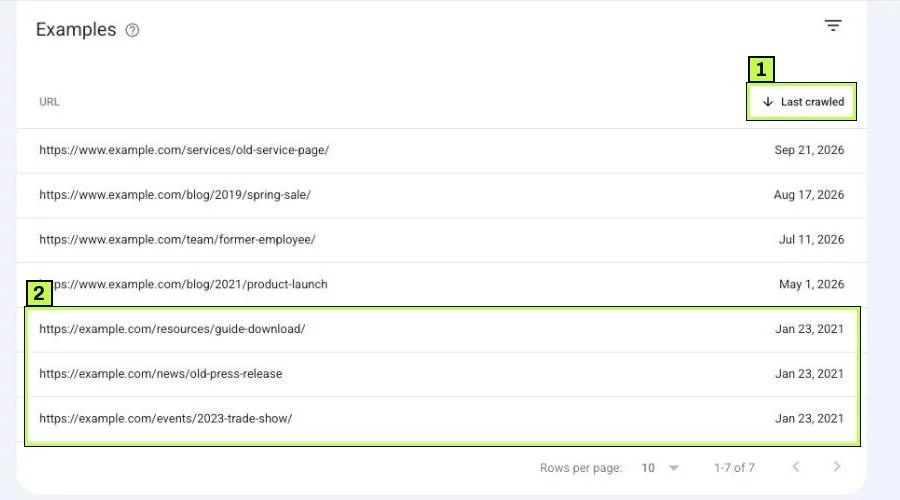
Más abajo, la tabla Examples lista URLs con su fecha Last crawled (último rastreo). La ayuda de Google aclara que esta lista no necesariamente muestra todas las URLs afectadas y que tiene un tope de 1,000 filas. Para detectar patrones es suficiente.
Paso 2: Agrupa las URLs
Abre la exportación y agrega una columna llamada "Grupo". Recorre la lista y etiqueta cada URL. Casi siempre caen en unos cuantos grupos.
| Grupo | Ejemplos | Qué hacer |
|---|---|---|
| Páginas importantes | Servicios, productos, artículos pilar | Mejorarlas y enlazarlas (pasos 3 a 5) |
| Casi duplicadas | Páginas de etiquetas, categorías filtradas, páginas por ciudad con el nombre cambiado | Consolidarlas o canonicalizarlas |
| Restos técnicos | Feeds (/feed/), ?replytocom=, archivos paginados, resultados de búsqueda, páginas de adjuntos |
Dejar de enlazarlas o generarlas; ignorarlas |
| Viejas o vencidas | Eventos pasados, productos agotados, noticias viejas, páginas de exempleados | Actualizar, redirigir o devolver 404/410 |
| Archivos | PDFs, imágenes, URLs JSON o XML | Casi siempre está bien dejarlas así |
Sé honesto en este paso. Una lista donde la mayoría de las filas son feeds y archivos de etiquetas de WordPress no es un problema. Esas páginas no necesitan posicionar. Las pocas que sí importan son tu verdadera tarea.
Ordena por ruta de URL para ver patrones rápido. Si ves la misma plantilla una y otra vez, el arreglo va en la plantilla, no página por página.
Paso 3: Inspecciona tus URLs importantes
Toma de tres a cinco URLs del grupo "Páginas importantes" y pega cada una en la barra de arriba de Search Console que dice Inspect any URL in seguida de tu propiedad.
Revisa tres cosas.
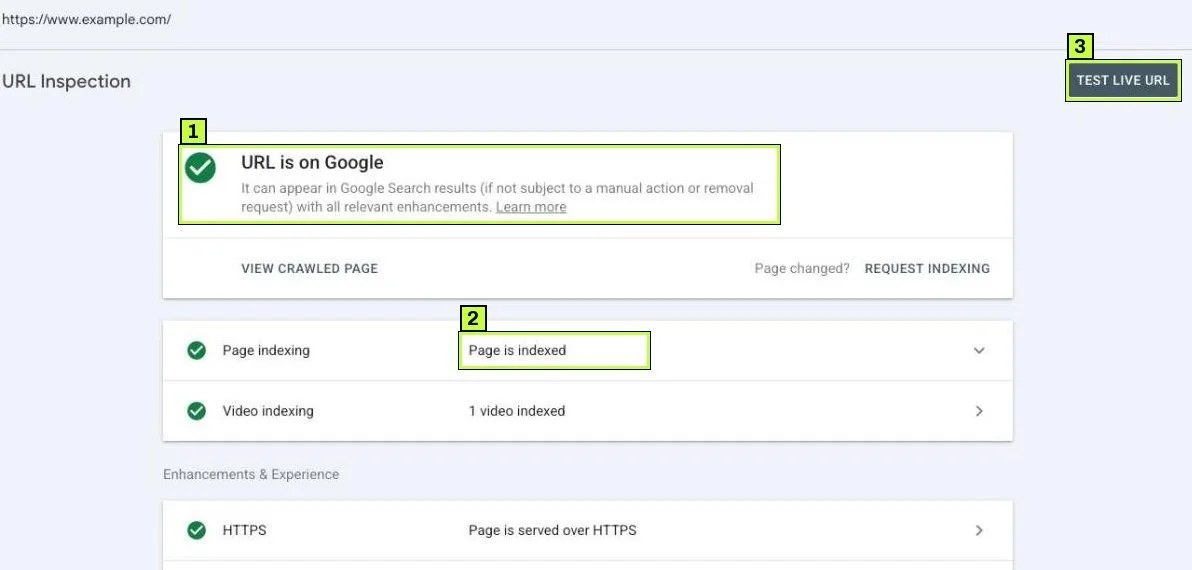
¿Ya está indexada? El informe Page indexing se actualiza más lento que la inspección. Si el resultado dice URL is on Google (la URL está en Google), el informe va atrasado y puedes seguir.
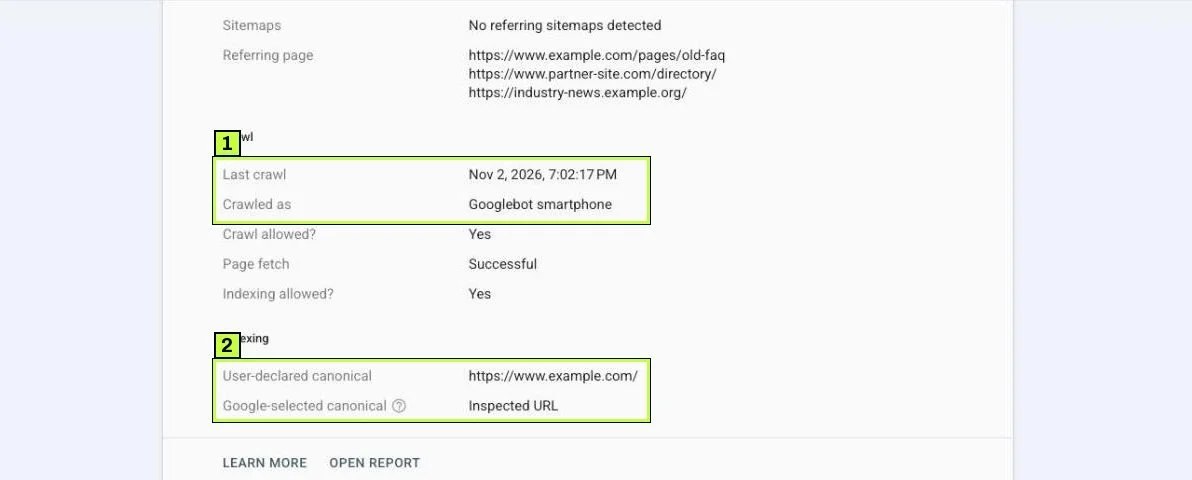
¿Cuándo se rastreó por última vez? Despliega Page indexing y mira Last crawl (último rastreo) y Crawled as (normalmente Googlebot smartphone). Si la fecha es anterior a tu último cambio grande, Google evaluó una versión vieja de la página.
¿La página se renderiza completa? Haz clic en Test live URL y luego en View tested page (ver página probada). Revisa la captura y el HTML renderizado, y abre More info para ver recursos que no cargaron y mensajes de la consola de JavaScript. Si tu contenido principal se carga con JavaScript y el HTML muestra un cascarón vacío como este, Google puede estar viendo una página casi sin contenido:
<body>
  <div id="app"></div>
  <script src="/bundle.js"></script>
</body>
Eso es un problema de renderizado. Tu desarrollador tiene que entregar el contenido principal en el HTML inicial, o corregir los errores de scripts y recursos bloqueados que lista More info.
¿Tiene canónica? Si User-declared canonical (canónica declarada por el usuario) dice None, agrega una etiqueta canónica que apunte a la misma página. No obliga a indexar, pero quita una duda sobre qué URL prefieres. Si Google-selected canonical (canónica elegida por Google) muestra otra URL, en realidad tienes un problema de duplicados; revisa nuestra guía de canónicas.
Paso 4: Mejora las páginas que sí deben indexarse
Este es el arreglo de verdad. La guía de Google sobre contenido útil pregunta si una página ofrece valor original y sustancial frente a otras páginas, incluidas otras de tu propio sitio. Revisa cada página importante con estas preguntas.
¿La página es pobre?
Una página de servicio con 80 palabras y un formulario no le da a Google mucho con qué trabajar. Agrega la información que un comprador de verdad necesita: qué incluye, para quién es, cómo funciona el proceso, preguntas frecuentes, rangos de precio si los publicas y pruebas, como detalles de casos que tengas permiso de compartir. Escribe para alguien que está decidiendo si te contrata, no para llegar a un número de palabras.
¿Se encima con otra página?
Dos artículos que responden la misma pregunta compiten entre sí, y Google puede quedarse solo con uno. Elige el más fuerte, pásale lo útil del más débil y redirige con un 301 la URL débil hacia la fuerte. En nuestra guía sobre duplicados y canónicas explicamos cómo decidir.
¿Es una plantilla con una palabra cambiada?
Las páginas por ciudad o por variante de producto que solo cambian el nombre de la ciudad o el color suelen terminar aquí. Dale a cada una contenido realmente único (detalles locales, inventario específico, fotos reales) o júntalas en una sola página.
¿Está desactualizada?
Los artículos viejos con enlaces rotos, fechas pasadas y consejos obsoletos se ven de poco valor. Actualiza los datos, renueva los ejemplos y cambia la fecha visible de "actualizado" solo cuando hayas hecho cambios reales.
¿El contenido principal está en el HTML?
Si el paso 3 mostró que falta contenido en el HTML renderizado, arregla eso primero. Lo que Google no ve no cuenta.
Paso 5: Refuerza los enlaces internos
Google usa los enlaces para encontrar páginas y entender cuáles importan. Un artículo al que solo se llega desde la página 9 del archivo del blog manda una señal débil.
Para cada página importante:
- Enlázala desde el inicio, el menú principal o una página central donde tenga sentido.
- Agrega enlaces en contexto desde dos o tres artículos relacionados que ya estén indexados, con texto descriptivo en lugar de "haz clic aquí".
- Confirma que esté en tu sitemap XML, y que el sitemap solo incluya URLs que quieres indexar.
- Quita los enlaces internos que apuntan a las URLs basura del paso 2, como páginas de etiquetas que decidiste no conservar.
<!-- Débil -->
<a href="/servicios/auditoria-seo/">Haz clic aquí</a>

<!-- Mejor -->
<p>Antes de un rediseño, hacemos una <a href="/servicios/auditoria-seo/">auditoría técnica de SEO</a>
para encontrar las páginas a las que los buscadores no llegan.</p>
Paso 6: Limpia las URLs de poco valor
No necesitas que todas las URLs estén indexadas. Para los grupos que "no importan", elige el arreglo más ligero que evite que distraigan a Google.
| Tipo de URL | Acción sugerida |
|---|---|
| Archivos de etiquetas y autores en un blog pequeño | Márcalos noindex en tu plugin de SEO o deja de enlazarlos |
Resultados de búsqueda interna (/?s=) |
No los enlaces; pon noindex en la plantilla |
URLs de feed viejas (/feed/) |
Déjalas; son comunes e inofensivas |
| Eventos o productos vencidos sin reemplazo | Devuelve 404 o 410 |
| Productos vencidos con un reemplazo cercano | Redirige con 301 al reemplazo |
Variantes con parámetros (?sort=, ?color=) |
Canónica a la URL limpia; evita enlazar parámetros |
No bloquees estas URLs en robots.txt como primera medida. El bloqueo impide que Google vea tus etiquetas canónicas o noindex, y puedes terminar con Indexed, though blocked by robots.txt (indexada aunque bloqueada por robots.txt). Revisa cómo resolver robots.txt y noindex para saber cuándo sí conviene bloquear.
Paso 7: Solicita la indexación y valida
Cuando tus páginas importantes estén actualizadas, inspecciona cada una otra vez, corre Test live URL y haz clic en Request indexing (Solicitar indexación). Hazlo solo con unas cuantas páginas clave. Google pone un límite diario por propiedad, y su documentación dice que repetir la solicitud de la misma URL no la rastrea más rápido.
Luego regresa al detalle de Crawled - currently not indexed y haz clic en Validate fix una sola vez. La ayuda de Google dice que no vuelvas a hacer clic hasta que la validación termine bien o mal. El estado pasa por estas etapas:
| Estado | Significado |
|---|---|
| Not started (no iniciada) | Algunas instancias nunca han estado en una solicitud de validación |
| Started (iniciada) | La validación está en curso y todavía no encuentra instancias pendientes |
| Looking good (buen aspecto) | Todas las instancias revisadas hasta ahora están corregidas |
| Passed (superada) | Ya no queda ninguna instancia conocida, o las URLs ya no existen |
| Failed (fallida) | Suficientes páginas siguen con el problema después de validar |
Como este estado es un juicio de calidad, la validación puede terminar en Failed aunque tus páginas importantes sí se hayan indexado. Pasa porque las URLs basura que decidiste dejar siguen en la lista. Mide el éxito por tus páginas importantes, no por la etiqueta de validación.
¿Sigue sin funcionar? Causas comunes
| Síntoma | Causa probable | Solución |
|---|---|---|
| Cada artículo nuevo cae aquí | Los artículos son cortos, parecidos entre sí o están mal enlazados | Publica menos artículos y más completos; enlaza cada uno desde artículos relacionados y una página central |
| Toda una categoría de productos afectada | Descripciones pobres copiadas del fabricante | Escribe descripciones originales y agrega especificaciones, preguntas frecuentes y fotos reales |
| Páginas que estaban indexadas y pasaron a este estado | Google reevaluó la calidad, o una página parecida ya cubre el tema | Actualiza el contenido, busca solapamientos y consolida |
| La captura de la prueba en directo sale vacía o incompleta | Falla el renderizado con JavaScript o hay recursos bloqueados | Corrige los errores de scripts; no bloquees CSS ni JS en robots.txt |
Casi todo son URLs ?page=2, /feed/, /tag/ |
Subproductos normales del CMS | Ignóralas o ponles noindex; deja de enlazarlas cuando puedas |
| El conteo crece después de una migración | Las URLs viejas siguen accesibles sin redirección | Agrega redirecciones 301 a las URLs nuevas |
| Una página importante sigue atorada por meses | Pocos enlaces internos o externos, dudas de calidad en todo el sitio | Enlázala desde tus páginas más fuertes; poda o mejora las secciones débiles |
| Muchas páginas afectadas en un sitio joven | El sitio todavía tiene poca autoridad | Concéntrate en menos páginas y más fuertes; gana enlaces reales con el tiempo |
Cuando el problema es de todo el sitio
Si casi todo tu sitio está en este grupo, mira más allá de las páginas sueltas. Un sitio con cientos de páginas pobres o generadas en automático le hace más difícil a Google confiar en el resto. Podar las secciones débiles (fusionarlas, mejorarlas o quitarlas) suele ayudar a que las demás páginas se indexen. Hazlo con calma y conserva todo lo que reciba tráfico o enlaces.
Cuando en realidad es un problema de «Descubierta»
Si Last crawled muestra una fecha de hace meses o años y la página cambió mucho desde entonces, puede que Google no haya visto tus cambios. Solicita la indexación y confirma que la página esté en el sitemap con una fecha lastmod correcta. Si Google no está rastreando nada, revisa cómo solucionar «Descubierta: actualmente sin indexar».
Cómo confirmar que quedó resuelto
- Vuelve a inspeccionar cada URL importante una o dos semanas después de solicitar la indexación. Busca URL is on Google y Page is indexed en la fila Page indexing.
- Revisa la fecha de Last crawl. Debe ser posterior a la publicación de tus cambios. Si no, Google todavía no ve la versión nueva.
- Vigila el recuadro Indexed en Indexing > Pages durante dos a cuatro semanas. Lo que quieres es que tus páginas importantes pasen a indexadas, aunque el total sin indexar casi no cambie.
- Abre Performance > Search results (Rendimiento > Resultados de búsqueda), filtra por página y confirma que empiezan a aparecer impresiones en las URLs corregidas.
- Sigue el estado de la validación, sin olvidar que Failed puede significar solo que quedan URLs de poco valor.
La ayuda de Google dice que la validación suele tardar hasta unas dos semanas, aunque puede tardar más. Los cambios de contenido pueden tardar unas semanas en reflejarse, así que no reescribas la misma página otra vez a los tres días.
Preguntas frecuentes
¿«Rastreada: actualmente sin indexar» es una penalización?
No. No es una acción manual ni una penalización. Significa que Google decidió no indexar la página por ahora. Las acciones manuales aparecen en su propio informe, dentro de Security & Manual Actions (Seguridad y acciones manuales).
¿Debo seguir haciendo clic en Request indexing?
No. Una solicitud después de un cambio real es suficiente. Repetirla no acelera el rastreo, y Google no indexa una página solo porque se lo vuelvas a pedir.
¿Las páginas pueden salir solas de este estado?
Sí. Google puede indexarlas más adelante, sobre todo cuando ganan enlaces o el sitio crece. Algunas URLs también entran y salen del índice con el tiempo.
¿Importa el número de palabras?
No como meta. Lo que importa es si la página responde la pregunta del visitante mejor que otras. Algunas páginas cortas se indexan sin problema y algunas largas no.
¿Debo borrar todas las páginas de la lista?
No. Borra o redirige solo las páginas que de verdad no sirven o están duplicadas. Muchas URLs de esta lista son subproductos inofensivos, y borrar páginas buenas te puede costar tráfico.
¿Te atoraste con esto? Lo resolvemos para clientes cada semana. Agenda una auditoría gratis
Fuentes
- support.google.com: /webmasters/answer/7440203
- support.google.com: /webmasters/answer/9012289
- developers.google.com: /search/docs/fundamentals/creating-helpful-content
- developers.google.com: /search/docs/crawling-indexing/consolidate-duplicate-urls
- developers.google.com: /search/docs/crawling-indexing/ask-google-to-recrawl
